读见

AI 精选周刊

NO.115Ginolujiaxian

BestBlogs.dev 第 115 期:贴身的智能

第 112 期谈「可托付的智能」,问的是敢不敢把工作交给它。本周这个问题有了新答案:OpenAI 在 DevDay 推出个人智能体 Dots,Manus 发布独立应用 Cue,Meta 的 Muse 刚登顶 App Store,xAI 干脆买下 dot.com 域名给 Grok Bot 引流。四家同题竞逐,个人智能体从概念变成产品发布潮。

20 条

本期内容已更正:上游成品更新 查看前一版

作者 Koray Kavukcuoglu
Gemini 4 Argon:我们 frontiers 智能时代的下一章(在新标签页打开)

推荐理由

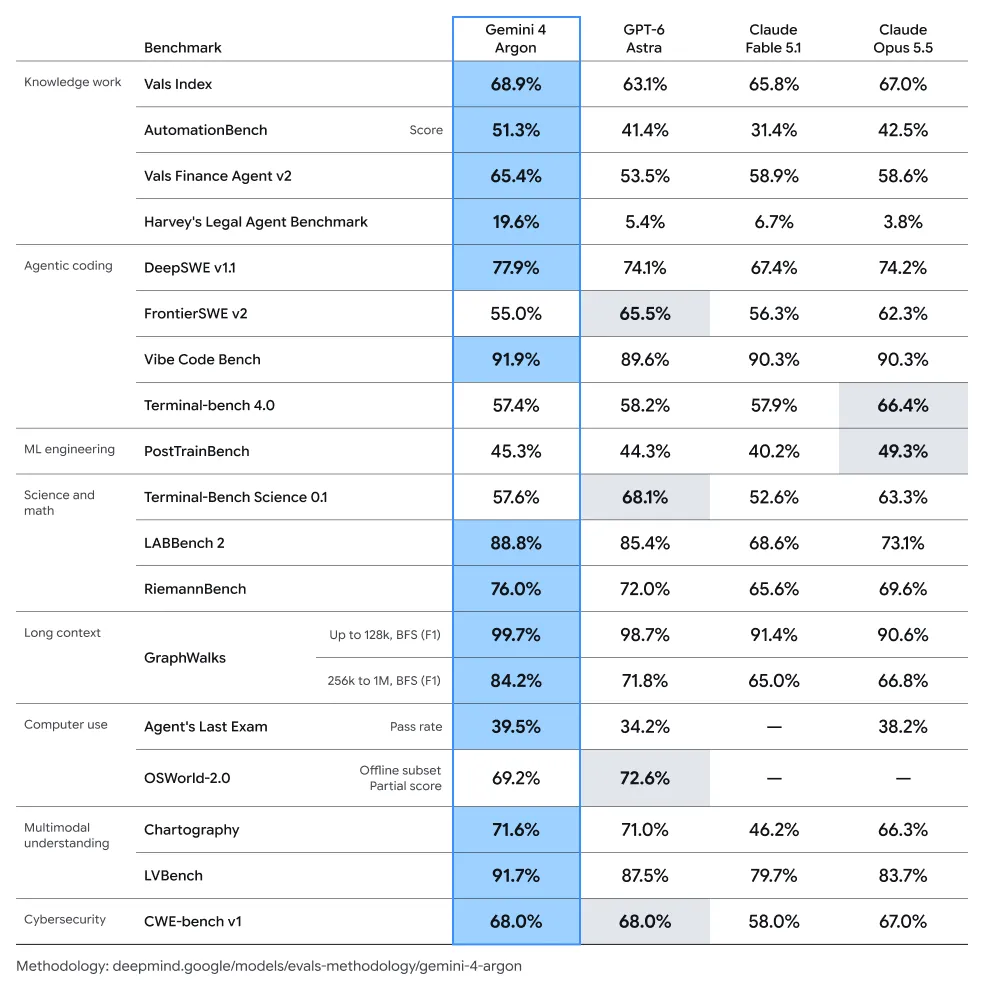
Google DeepMind 发布前沿模型 Gemini 4 Argon:定价 2/10 美元,输出 token 上限从 64K 扩到 100 万,面向复杂长程任务。发布方式同样值得注意:先经 Fairwind 计划开放给受信任的网络防御者,收集护栏反馈后再逐步扩大。Google 内部战果具体:量子子程序优化超过公开基线 40%,智能体群分析全集群画像释放 300 TiB 以上内存,libgav1 的 32K 行 SIMD 重写为安全 Rust 后快 2.7 倍。观察前沿能力与分阶段发布治理的一手窗口。

Google DeepMind 推出 Gemini 4 Argon,这是其下一代 frontier 模型,专为软件工程、企业知识工作和网络安全防御等复杂的长时程工作流程中的深度推理而打造。Argon 首先通过 Fairwind Program 提供给值得信赖的网络安全防御者,并遵循美国政府的预发布访问流程进行分阶段发布。在内部,它已经帮助优化量子子例程(比已发布基线提高 40%)、释放超过 300 TiB 的数据中心内存,并将大型 C/C++ 代码库迁移到 Rust,包括在 libgav1 中替换 32K 行 SIMD 代码,使内存安全解码器速度提升 2.7 倍。该模型将输出 token 上限提升至行业领先的 100 万 token,并在 DeepSWE v1.1(77.9%)、Vals Index、Vals Finance Agent v2、Harvey's Legal Agent Benchmark、AutomationBench(51.3%)、LVBench(91.7%)和 CWE-bench v1(68%)上实现了最先进的结果。Google 还详细介绍了四个安全保障领域:滥用防御、提示词注入鲁棒性、错位监控和系统强化。入门定价为每百万输入 token 2 美元、每百万输出 token 10 美元,缓存输入折扣高达 95%。

作者 OpenAI

GPT-6.1 Sol 正式发布(在新标签页打开)

OpenAI 发布了 GPT-6.1 Sol,这是 Sol 模型的升级版,旨在平衡高性能与显著降低的成本。它在智能体编码(DeepSWE v1.1)、专业文档分析(GDP.pdf)、业务工作流自动化(AutomationBench)和计算机使用(OSWorld 2.0)方面的表现几乎媲美旗舰模型 GPT-6 Astra,但价格仅为 Astra 标准 Token 定价的 20%。值得注意的是,该模型采用了极具竞争力的缓存输入价格,每百万 Token 仅需 0.10 美元,以支持上下文密集型智能体。此外,相较于 GPT-6 Sol,新模型在事实准确性和安全对齐方面均有提升,特别是在工具故障透明度和遵守用户约束条件方面表现更佳。

推荐理由

OpenAI 在 GPT-6 Sol 发布仅七天后推出 GPT-6.1 Sol:以 Astra 五分之一的价格(输入 2 美元、输出 10 美元、缓存输入低至 0.10 美元每百万 token)逼近其智能体编码、电脑操作与专业工作表现。DeepSWE v1.1 上追平 Astra,GDP.pdf 专业文档任务以不到一半成本胜过带回退的 Opus 5.5。前沿能力进入日用价,是个人智能体全天候随行的经济前提。适合做模型选型与智能体成本预算的开发者和架构师。

Anthropic 发布 Claude 5.5 家族第二款模型 Sonnet 5.5,面向日常编程、修 bug 及文档、幻灯片、表格等工作。官方称输出生成速度提升 30% 以上,多数任务单任务成本最多降低 30%,API 单价维持每百万输入 token 2 美元、输出 token 10 美元不变。文章引用 CursorBench 4.0 数据说明:Sonnet 5.5 在 Low effort 下得分 35.8%、成本 0.50 美元,已略高于 Sonnet 5 Max 的 34.1%、7.17 美元,平均步骤从 140 降到 18;但 Xhigh 到 Max 得分仅从 53.1% 升到 55.5%,成本却从 3.88 美元涨到 9.67 美元,而 Opus 5.5 High 以不到一半花费取得接近 Sonnet 5.5 Max 的得分。文章还分析了效率来源(更常合并工具调用、缩短行动链)、effort 拉满可能做过头(FrontierCode 上 Xhigh 52.1% 反超 Max 46.2%,因 code-review skill 触发子 Agent 导致超时或超范围修改),以及 GDPval-AA 办公设计评测表现和 API 迁移注意事项。

推荐理由

Anthropic 发布 Claude Sonnet 5.5:输出生成提速 30% 以上,单任务成本最多降 30%,单价不变。这篇文章的价值在算账:CursorBench 4.0 里 Sonnet 5.5 的 Low 档得分超过 Sonnet 5 的 Max,平均步骤从 140 降到 18,成本从 7.17 美元降到 0.50 美元;而 FrontierCode 上 Xhigh 反而高于 Max,说明把推理档位拉满可能做过头。日常任务选型与 effort 档位配置的实用参考。

作者 Mati Staniszewski、Piotr Dabkowski

Eleven v4:我们最具表现力的文本转语音 AI 模型(在新标签页打开)

ElevenLabs 发布了其最先进的文本转语音模型 Eleven v4 和低延迟变体 Eleven v4 Turbo。这些模型基于全新的架构构建,优先考虑情感深度和自然度,而非单纯的机械准确性。在与 Cartesia 和 Google 等竞争对手进行的盲测中,Eleven v4 因其在语调、节奏和语境理解方面的能力,获得了约 75% 听众的偏好。一项关键创新是支持内联音频标签(例如 [laughs]、[said angrily])和自然语言指令提示,允许用户微调表达方式。Turbo 模型解决了速度与质量之间的权衡问题,实现了约 150ms 的中位首字发声时间,使其适用于对话式智能体。此外,此次更新将仅凭 10 秒音频即可实现的声音克隆保真度进一步提升,并支持超过 90 种语言,同时改善了跨语言的口音保留效果。

推荐理由

ElevenLabs 发布最具表现力的文本转语音模型 Eleven v4:在 Artificial Analysis 排名第一,盲测对比中获得约 75% 听众偏好,能理解语气、节奏、情绪与上下文,多说话者交互更自然;配套 v4 Turbo 中位推理延迟约 100 毫秒,比两个人对话间的停顿还快,专为实时智能体语音而生。当个人智能体常驻身边,语音是它开口的第一界面。适合关注语音与多模态产品的读者。

作者 Simon Willison

2026 年 LLM 发展回顾(截至目前)(在新标签页打开)

本文基于 Simon Willison 在 WeAreDevelopers World Congress 闭幕主题演讲,对 2026 年前三个季度大语言模型领域的发展进行了时间线回顾。叙述始于 2025 年 11 月的一个关键拐点,Claude Opus 4.5 和 GPT-5.1 的发布将编码智能体从不可靠的工具转变为日常可用工具。Willison 描述了自己经历「AI 狂热」的个人体验,由此催生了基于 Python 的 JavaScript 解释器等过于雄心勃勃的项目,并讨论了「Deep Blue」现象——工程师面对 AI 无处不在时产生的职业倦怠感。

一个主要主题是 Claw 类别的爆发:源自 OpenClaw 仓库的通用个人智能体获得了大规模采用,并衍生出众多变体。文章还涵盖了 MoltBook 的迅速兴衰——一个被 Meta 收购的智能体对智能体社交网络,以及 StrongDM 备受争议的「软件工厂」模式,该模式要求代码既不由人类编写也不由人类审查。最后,文章提到了 Google 在 2 月发布的 Gemini 3.1 Pro,标志着多模态能力和创意生成方面的进一步改进。

推荐理由

Simon Willison 在 WeAreDevelopers 大会闭幕演讲的注释讲义:他把 2026 年的拐点定在 2025 年 11 月,Opus 4.5 与 GPT-5.1 让编码智能体从「经常出错」变成「日常可用」。此后用骑自行车的鹈鹕图表、名不见经传的 Warelay 仓库首个 commit、以及「要更有野心」的新年决心,串起独立开发者重新放开手脚的一年。当个人智能体成为各家共同的新战场,这份可核对的一手时间线是最好的背景板。

作者 数字生命卡兹克

帮大家总结了一下凌晨的 OpenAI 2026 开发者大会。(在新标签页打开)

OpenAI 在 2026 DevDay 上发布了多项重磅功能。核心内容包括:1. 个人 Agent Dots,支持 24 小时在线执行,具备云电脑和浏览器环境;2. GPT-6.1 Sol 模型,在发布仅 7 天后快速迭代,通过降低缓存价格提升 Agent 任务性价比;3. ChatGPT Space,将文档、计划、图表与原型整合的 Agent 协作空间;4. Codex Cloud,引入可复用开发环境解决重复初始化问题;5. 生态构建,打通第三方产品订阅,并推出 OpenAI Marketplace。作者指出,AI 的逻辑正从“Human-first”转向“Agent-native”。

推荐理由

卡兹克通宵蹲完 OpenAI DevDay 2026 的中文全景整理:个人智能体 Dots 向 Pro、Business、Enterprise 用户推出,每个 Dot 有自己的云电脑与执行环境,可联动 ChatGPT 生态超过 4000 个应用,并预告短信与电话入口;ChatGPT Space 把「Human + Agent Native」的工作空间变成现实。另有扫描过 3000 多万 commit 的 Codex Security Cloud 靠定时扫描变成常驻安全智能体,以及订阅随身带、Figma 与 Adobe 整页嵌入等生态更新。大厂集体押注个人智能体的一周,这是最完整的中文整理。

在这场深度对话中,来自 Anthropic 的 Thariq Shihipar 探讨了智能体编程如何从一项充满争议的实验迅速转变为行业默认做法。讨论涵盖了 Claude Code 框架的技术演进,包括将「Artifacts」用作持久化生成式界面,以及引入「Claude Mods」来自定义智能体行为。Shihipar 提出了「可变软件」的概念,即应用程序由智能体动态构建和定制。对话还涉及框架工程的「苦涩教训」,以及在智能体展现出逆向工程基准测试和串联基础设施漏洞的能力之际,对「Pacing the Frontier」等新安全范式的迫切需求。

推荐理由

Latent.Space 对话 Anthropic 的「解释者担当」Thariq Shihipar:从 Claude Tag、Opus 5.5 一路数到当天发布的 Sonnet 5.5,半年发布线一次理清;再指向下一步:Claude Mods 定义「可变软件」,像改代码一样改造工具,社区已经玩出 Claude 里的俄罗斯方块;Claude Projects 让会话管理消失,想法随到随发。配合官方 mods 发布文食用,是理解 Claude Code 生态「下一个时代」最省力的地图。

Anthropic 宣布推出 Claude Code 的 mods:小型 TypeScript 函数挂钩到操作过程中释放的事件(工具调用、权限请求、UI 渲染)之前、之后、取而代之或环绕它们运行。单个 mod 可以在提示词到达模型之前重写它们,阻止或重试工具调用,批准或拒绝权限,从工具输出中清除机密信息,并通过按钮和输入编辑或扩展界面。mods 随插件一起发布,因此它们的安装和共享方式与任何插件相同,并且它们以与 Claude Code 本身相同的非沙盒机器访问权限运行。钩取同一事件的多个 mods 按加载顺序依次执行,允许跨作者堆叠。一些内置功能(如 /diff)现在也作为 mods 发布,可以被禁用或替换,后续还有更多功能计划这样做。对于团队和企业,现有的插件控制措施适用,且一个内置的 sec-default mod 优先加载,以阻止用户安装的 mods 除非管理员覆盖它。mods 今天已在 CLI 和桌面应用中提供。

推荐理由

Anthropic 推出 Claude Code mods:小型 TypeScript 函数挂钩工具调用、权限请求、界面渲染等事件,可在事件前后或代替事件运行,实现重写 prompt、拦截重试工具调用、对输出脱敏,甚至替换内置功能、增改 UI,部分内置功能本身已改由 mods 交付。它不跑沙箱、拥有与 Claude Code 相同的机器权限,只应安装可信来源。让开发者直接重塑智能体的工作方式,这是工具走向「属于你」的又一步。

作者 Addy Osmani

无人阅读的代码(在新标签页打开)

Osmani 重新审视了他此前关于审查所有 AI 生成代码的建议,指出虽然每个变更仍然需要有人负责,但审查方式正在发生转变。他对比了两篇近期热传的文章:一篇预测代码审查将消亡(Thorsten Ball),另一篇描述了盲目批准 AI 代码的痛苦(v0xium)。Osmani 认为,只有当行业拥有了替代性的信任机制——具体而言,即低成本的自动化检查和清晰的爆炸半径边界——才会停止阅读大部分代码。他重点介绍了 Anthropic 的内部实践,即自动化审查者捕获 bug,但由人类决定什么可以发布,并指出审查此前承担的教育和文化功能如今需要显式文档化。文章警告不要在未以严格验证替代的情况下移除人类监督,强调测试必须独立于代码生成器(引用 SQLite 和航空标准),以避免奖励黑客行为。最终,他建议工程师专注于理解意图和保持问责,而非仅仅打字或按回车键。

推荐理由

Addy Osmani 修正自己两年前「逐行审查生成代码」的建议:不必再读每一行,但每处变更仍需要一个「拥有发布决定的人」,逐行细读只是提供这种问责的方式之一。他给出替代信任机制:自动检查、爆炸半径边界、独立于生成方的测试、人机混合评审。Teleport 案例是最好的注脚:13 名工程师一个季度发现近两年总和的高危漏洞,发现变便宜了,确认与修复没有。当智能体写掉大部分代码,评审从读代码变成担决定。

作者 Sydney Runkle

如何在 Harness 中构建模型路由器(在新标签页打开)

前沿 LLM 成本高昂,大多数智能体任务并不需要前沿智能。LangChain 描述了为其开源编码智能体 Open SWE 构建模型路由器的过程——该路由器存在于 Harness 内而非通用网关,因为路由需要 Harness 已经整合的任务与领域上下文。团队首先分析了一周的 LangSmith 跟踪记录,绘制了任务类型(功能开发占 22%、漏洞修复占 17%、测试占 16%)及复杂度分布,随后沿成本-智能 Pareto 前沿选择了三款模型:一款快速开源模型、一款均衡模型和一款性能模型。路由器在线程的第一条人类消息上使用基础提示词、每层标准和分类器模型运行。在对 973 个线程进行的 A/B 测试中,对比始终使用最强模型的控制组,合并 PR 比率统计学意义平坦(29.2% 对 27.3%,p=0.49),而线程中位数成本从 2.61 美元降至 0.94 美元,降幅 64%。仅有 10% 的路由线程被分配至性能层级。该文章还讨论了通过合并 PR 和用户反馈进行结果跟踪、于一天内中止的纯快速控制测试,以及深度 SWE 基准测试、子智能体路由、线程中间重新路由等下一步计划。

推荐理由

LangChain 详解在 Open SWE 智能体 Harness 内自建模型路由器:先拉一周轨迹数据摸清任务分布,再沿成本与智能的 Pareto 前沿选三档模型,973 线程 A/B 显示质量持平、中位成本降 64%。核心判断是路由属于 Harness 而非通用网关:只有 Harness 手里握着任务与领域上下文。个人智能体要常驻身边,先把每一步的账算清,这篇是成本工程的必修教材。

作者 DeepSeek Harness 团队

DeepSeek Harness 桌面端:现在,开箱即用。(在新标签页打开)

DeepSeek Harness v0.2 预览版正式发布,核心变化是从命令行安装转向提供 macOS 和 Windows 桌面端安装包,极大降低了用户上手门槛。新版本优化了文件展示、内容预览和代码变更差异对比,并内置了可按需开启的自动化定时任务插件。在插件生态方面,新增了无需命令行的可视化插件管理页面,支持通过 npm 包名直接安装/卸载,并推出实验性的「创造模式」,允许用户通过对话让 AI 编写和修改插件。未来计划包括改善沙箱安全、引入长期记忆、实现 GUI 自动化操作以及建设官方插件市场,旨在构建一个开源、可组合的智能产品生态。

推荐理由

DeepSeek Harness v0.2 预览版发布,macOS 与 Windows 桌面端开箱即用:日常办公与开发能力内置,插件输入 npm 包名即可安装,自动化任务可在界面里设定与查看。官方口径下它已是 DeepSeek API 用户中最受欢迎的 coding agent,约 60% 用户在用第三方插件;路线图还排着沙箱、智能体团队与长期记忆。开源、可组合、装在本地,是个人智能体工作台浪潮里门槛最低的一档。

本文详细复盘了阿里稳定性团队在 2026 年推进 AI Native 研发转型的实践。针对 AI 生成代码导致风格不一、难以接手及协作链路冗长等痛点,团队开发了结构化规则包 Skill,通过 When/What/Don't/How/Map 五维结构将专家经验转化为 AI 可执行的约束,并构建了集成工作台 Anchor 简化能力装配。在协作模式上,团队通过「原型库与正式库分库」解决了设计与前端的节奏冲突,将还原成本大幅降低。同时,文章提出了 PDFE(产品-设计-前端工程师)复合角色概念,探讨了 AI 全栈开发的适用边界与 ROI,并分享了一系列将个人效率转化为团队能力的 AI 助手实践。

推荐理由

阿里稳定性团队前端工程师王僖一手复盘半年 AI Native 转型:人人都能用 AI 生产代码之后,被漏算的是「生产之后」的对齐约定、交接评审与原型处置;上课、建知识库、换平台三条常规路径接连走不通,出路是把顺序倒过来,用结构化 Skill 和 Anchor 插件让规则在生成的那一刻到场,设计与前端从共用代码改为分库,并附复用率与工期数据。智能体大规模参与生产后,质量机制如何跟上的里程碑案例。

本文详细记录了高德本地生活团队在 S1 期间推进 AI Native 转型的实战经验。针对 AI 生成代码导致的风格不一、难以接手及协作链路冗长等痛点,提出了一套方法论:通过定义 L0-L4 能力分级对齐目标,构建三层能力框架(基础底座、分析能力、产品交互)来实现经营分析智能体。同时,作者深入探讨了在 AI 时代 BI 工程师的角色转变,从单纯的报表生成转变为经营判断的设计者与守门人,并通过知识蒸馏和语义治理让经验转化为数字资产。

推荐理由

高德本地生活团队万字复盘 AI Native 转型:以 L0-L4 能力分级对齐转型目标,用三层框架搭建经营分析智能体,再以知识蒸馏与语义治理把资深经验沉淀为数字资产。BI 工程师从做报表转向做经营判断的设计者与守门人,对正在推进企业 AI 落地的团队是一份少见的全景式一手实践。

Manus 2.0 重构了底层 Agent 架构,推出 Cascade 自研 Agent Harness,实现 Token 消耗减少 23.2%、任务完成时间缩短 28.2%、运行成本降低 32%。Cloud Computer 提供独立云端运行环境,Automations 支持事件触发工作流。Manus Studio 升级为共享工作空间,支持视频编辑、游戏开发等专业环境。Cue 应用推出,支持个人 Agent 场景,可独立执行任务并连接日常服务。Manus 2.0 旨在将想法变成现实,延续了从生成到完善和交互的完整流程。

推荐理由

Manus 2.0 携自研 Agent Harness Cascade 回归:内部测试显示 token 消耗降 23.2%、任务完成时间缩短 28.2%、运行成本降 32%;Cloud Computer 给项目一块全天候的独立云端运行环境,Automations 从定时任务升级为邮件、日历、Slack 等事件触发的工作流。独立应用 Cue 更进一步:每个智能体有自己的邮箱、电话号码、钱包和电脑,可组队分工,也能扫码点餐、代人排队。这是给个人智能体配齐身份与住址的一次完整尝试。

本文报道了戴夫·海诺迈尔·汉森(DHH)在 Rails World 主题演讲上宣布,37signals 已经“放下笔”不再手写代码,将 Opus 4.5 的 2025 年 11 月发布视为智能体时代的拐点。DHH 透露 37signals 正在开发原生移动应用,正在将后端服务迁移到 Rust,并表示他不再认为自己是一名专业程序员。作者把这与他本年一月的预测——即 AI 将编写几乎所有代码——相联系,并记录了这段混乱的转变过程:一位匿名的大科技工程师发布了关于令人精疲力尽的 AI 驱动工作流程的病毒式吐槽;软件质量下降;以及他在 Uber Eats 新添加项选择器中发现的三个粗陷的 Bug。作者用一种违反直觉的方式论述,即软件工程将变得更加重要而非更少重要,因为工程师们必须理解 LLM 的特征,为智能体驱动的软件工厂构建验证系统,并探索使用 LLM 生成确定性代码,如比 LLM 调用更快更便宜的 linter。

推荐理由

每日脉动:DHH 在 Rails World 宣布 37signals 已「放下笔」不再手写代码,并将 Opus 4.5 视为智能体时代拐点。作者 Ivan Klaric 串联软件质量争论与真实 bug 案例,给出反直觉判断——软件工程反而更重要:工程师要理解 LLM 特性、为智能体工厂构建验证系统、用确定性代码(如 linter)兜底。适合关注 AI 编程转型的一线工程师与技术负责人。

在 Instagram 和 Google Search 产品领域工作近 20 年后,Robby Stein 指出,AI 降低了执行成本,也让产品经理的核心贡献转向判断力:决定什么值得开发,以及产品是否真正适合用户。他建议还原用户做出选择时的背景,找出他们希望借助产品完成的任务,再确认真正的障碍,而不是一味增加功能。Instagram Stories 的改进回应了用户对私人内容被谁看到的担忧;创作者的反馈则促使 Reels 从短暂展示转向持续留存和触达观众。对于 Google 的 AI 体验,多模态灵感和可信的本地信息比单纯提供文字答案更贴合需求。最后,Stein 谈到产品打磨:消除痛点、创造愉悦感,并借助智能体规模化评估质量,同时让体验保有人情味。

推荐理由

Google Search 产品负责人 Robby Stein 认为:AI 把执行变得便宜,PM 的核心价值转向判断力——还原用户选择场景、找真正要完成的任务、用迭代解决根因。Stories 与 Reels 演进案例+Google AI 体验思考,适合重新定位角色的产品人。

Atlassian 首席产品官 Tamar Yehoshua 认为,AI 正在拓展产品、设计和工程岗位的职责,而不是简单地让这些角色消失。当亲自参与能解除瓶颈时,产品经理可以直接动手:在 Confluence,一个产品经理曾在一个月内提交 26 个 pull request,借助 AI 工作流,团队在 6 到 8 周内推出了新功能。在一个从零到一的项目中,产品经理先搭建 alpha 版本;当编码不再是他最能发挥价值的工作后,他便转而明确方向、帮助工程师排除阻碍。对于成熟的 Jira,产品经理则通过可复用原型和自动化反馈分类来引导工作,同时不直接修改生产代码。团队称,其吞吐量约为平时的 3 倍,并在约 10 周内交付了 22 项面向客户的功能。Yehoshua 还介绍了 Atlassian 的 AI 熟练度培养计划,并强调应衡量已交付的工作和客户成果,而不只是活动量。这些案例共同说明,角色选择取决于具体情境:先掌握足够知识以便作出贡献,再根据团队当前的瓶颈,决定亲自划桨还是负责掌舵。

推荐理由

Atlassian CPO Tamar Yehoshua 分享 AI 如何改写产品分工:一位 PM 一个月提交 26 个 PR、团队吞吐 3 倍、10 周交付 22 项功能;判断框架看瓶颈——亲自上手解除阻塞还是掌舵定方向。适合思考 AI 时代产品角色的管理者。

Assistant Bench 创作者 David Pollen 与 a16z 主持人探讨快速增长的消费级智能体市场,并分享了对 122 款产品的基准研究和对 26 款产品的测试。他们认为,日常产品的价值未必来自节省几分钟,更可能来自追回款项、处理行政事务,例如申请健康支出报销、监控机票价格,或根据天气调整灌溉。对谈比较了聊天、应用、语音和环境式硬件等形态:主动服务可能成为竞争壁垒,但一次有害操作就足以摧毁用户信任。发言者看好依靠品味和专有知识竞争的垂直智能体,并区分了听从指令的助手与能自主采取行动的智能体。他们还讨论自主购物如何冲击广告驱动的市场、预订和消费发现,并催生智能体之间的服务。最后,双方质疑长尾创业公司能否承担每天每位用户约 20 美元的成本,尽管模型和浏览器操作成本正在下降。许多判断仍是有待验证的假设。

推荐理由

a16z 对谈 Assistant Bench 作者:基于 122 款消费级智能体的基准研究与 26 款实测,拆解「什么值得付费」——价值不在省几分钟,而在追回款项、报销、比价等主动事务;一次有害操作足以摧毁信任,主动服务与垂直专有知识才是壁垒,而每天约 20 美元的运营成本是长尾创业者的生死线。适合研究 AI 产品形态与商业模式的读者。

本期 42章经请到开源项目 Vibe-Trading 的作者与维护者吴浩哲(武汉大学数学系本科、香港大学在读博士、HKUDS 成员)。该项目 2025 年 4 月开源,不到半年在 GitHub 收获超过 3 万 star,来自 20 多个国家和地区的贡献者参与。他提出核心判断:在其他行业 AI 让执行变便宜、难的是决定做什么;但在金融里恰好相反——市场每秒报价、研究 agent 一天可以对几千只股票给出上百个判断,决策几乎免费,真正昂贵的是行动,因为每一单都要付手续费、亏损需自担且无法撤回。因此 AI Trading 不是让模型做更多预测或自动下单,而是在「几乎免费的决策」与「代价昂贵的行动」之间建立可验证、可审计的通道。他把系统归为四部分:模型智商、独家数据、数据对齐、harness,并认为后两者决定决策能否变成行动,价值在上升,而模型与独家数据带来的边际价值在下降。他也给出对市场结构的三点判断:信息被价格消化的速度会越来越快(「财报后漂移」已消失)、超额收益从单因子迁移到组合条件、错误与误导信息传播加速带来确权与监管难题。对 Jev 之类只给概率不给理由的工具,他认为对 trading 帮助约等于零,更适合做信息初筛的分拣员。最后他给出对普通投资者的建议:先隔离风险、明确风险偏好,把 AI 当作探索新市场与新领域的工具,并讨论「human in the loop」或许不是 AI 需要人,而是人需要通过参与确认自身意义。

推荐理由

Vibe-Trading 作者吴浩哲做客 42 章经:金融市场每秒报价让决策近乎免费,真正昂贵的是不可撤回的行动,AI Trading 的价值在两者之间架设可验证、可审计的通道。他把系统拆为模型、数据、数据对齐与 harness 四层,判断后两者价值正在上升。

作者 OpenAI

永恒的互补品(在新标签页打开)

这是 OpenAI 新平台 Intelligence Age 系列的第一篇随笔,作者 Hemanth Asirvatham 与 Elliott Mokski 明确声明观点仅代表个人。文章从「人类已能窥见宇宙开端却从未离开月球」这一反差出发,指出前沿智能与「实现想法的能力」在经济学上是互补品:伽利略的望远镜只需几十双手,而韦布望远镜则需要 14 个国家、300 个组织的协作。作者引用研究生产率下降、技术人员增速是科学家两倍、芯片厂成本上升等数据,说明进步的执行成本在增加,并提出「制度智能」概念——即由法律、官僚体系、资金机制与供应链构成的执行智慧。文章随后区分了两种未来:在「深度文明」中,超级智能靠推理与挖掘既有数据大幅节省对现实世界的查询;在「宽度文明」中,自然的复杂性使实验与建设需求增长快于智能的节省能力,AI 将主要被用于「做无聊的事」,如戴森球式的建造与物流。作者最后强调,即便机器在两方面都超越人类,人类的好奇心与追问仍具有不可替代的价值。

推荐理由

OpenAI 新 Intelligence Age 平台「下一个经济」系列首篇:天才机器最大的价值,可能在于接手单调的工作。文章引用 Nick Bloom 等人的研究:维持摩尔定律所需研究者已是 1970 年代的 18 倍,全经济科研生产率却降了 41 倍;天才只是生产过程的一种投入,执行才是更大的瓶颈。智能过剩而行动昂贵,正是「让个人智能体接管单调工作」的经济学注脚,也是发布狂欢后值得一读的冷静长文。

阅读设置

更多